
Kalau lo pernah bikin sistem RAG, lo tahu rasanya. Chunking, embedding, vector store, retriever, reranker, prompt. Semua itu ditulis di kode, tersebar di beberapa file, dan saling terikat. Mau naikkan top_k dari 5 ke 8? Ubah kode, jalanin test, deploy ulang. Mau ganti model embedding? Siapkan waktu buat rebuild index yang bisa berjam-jam.
Padahal yang berubah cuma satu angka.
Ada pola lain yang dipakai beberapa framework besar: definisikan flow-nya sebagai data, di file YAML. Haystack menyimpan pipeline-nya begitu. Prompt Flow dari Microsoft menyimpan satu flow sebagai satu folder berisi flow.dag.yaml. Google ADK memakai root_agent.yaml yang punya JSON Schema, sehingga editor bisa memvalidasi sambil lo menulis.
Artikel ini bukan buat bilang YAML lebih baik dari kode. Gue mau nunjukin perbandingannya dengan RAG yang biasa kita tulis di kode, di mana masing-masing menang, dan jebakan yang bikin sebagian tim balik lagi ke kode.
Kenapa RAG jadi default
RAG masuk ke meja lewat paper Lewis dkk tahun 2020, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Masalah yang mereka angkat waktu itu sederhana: model bahasa menyimpan fakta di dalam parameternya, tapi kemampuan mengakses dan memperbarui fakta itu terbatas. Paper-nya menyebut dua hal yang sampai sekarang masih relevan, yaitu memberi asal-usul jawaban dan memperbarui pengetahuan model tanpa melatih ulang.
Solusinya: pasangkan model dengan memori non-parametrik. Ambil dokumen relevan dari luar, taruh di konteks, biarkan model menjawab berdasarkan itu. Lebih dari lima tahun kemudian, polanya masih dipakai di mana-mana, dan gue pribadi belum lihat penggantinya yang benar-benar menggantikan.
Batas RAG yang diakui pembuatnya sendiri
Yang menarik, kritik paling tajam ke RAG datang dari tim yang justru membangun perbaikan di atasnya.
Tim Microsoft, di paper GraphRAG (2024), menulis bahwa RAG lemah untuk pertanyaan yang menghadap ke seluruh korpus. Pertanyaan seperti “tema utama dari kumpulan dokumen ini apa?” bukan tugas retrieval, itu tugas peringkasan. Pencarian vektor mengambil potongan yang mirip, sementara pertanyaan tadi butuh pandangan menyeluruh.
Tim Ant Group bersama peneliti Zhejiang University, di paper KAG (2024), menambahkan satu lagi: pencarian berbasis kemiripan vektor tidak sensitif ke logika knowledge. Angka, relasi waktu, dan aturan pakar adalah contoh yang mereka sebut. Dua potongan teks bisa punya skor kemiripan tinggi tanpa benar-benar berhubungan secara logis.
Paper CAG (2024) menyorot sisi sistemnya. RAG menambah latensi retrieval, membuka peluang salah pilih dokumen, dan menambah kompleksitas yang harus dijaga. Paper Self-RAG (2023) menyerang satu kebiasaan yang sering kita tiru tanpa pikir: mengambil sejumlah passage tetap, entah retrieval-nya memang perlu atau tidak.
Ada juga studi dari Google DeepMind bersama University of Michigan (2024) yang membandingkan RAG dengan model konteks panjang. Hasilnya cukup jujur: kalau sumber daya cukup, model konteks panjang konsisten lebih baik, tapi RAG tetap menang di biaya. Dari situ mereka mengusulkan Self-Route, memilih jalur secara otomatis.
Semua kritik itu tidak membuat RAG jadi usang. Yang berubah, jumlah parameter dan varian yang harus dijaga sekarang jauh lebih banyak, dan itu yang bikin pertanyaan berikutnya jadi penting.
Di mana flow itu ditulis
Ini bagian yang paling jarang dibahas waktu orang membandingkan arsitektur. Bukan cuma apa yang dijalankan, tapi di mana definisinya ditulis.
Di pendekatan yang paling umum, definisi itu tinggal di kode. Chunking di satu modul, index builder di modul lain, konfigurasi retriever di file ketiga. Hasilnya jalan, cuma ada biaya yang menumpuk pelan-pelan:
- Perubahan parameter harus lewat review kode, dan orang yang paham retrieval belum tentu nyaman membaca repo Python lo
- Eksperimen retrieval terikat siklus deploy, padahal yang diubah sering cuma angka
- Pertanyaan sederhana seperti “sistem ini sebenarnya mengambil dokumen dengan cara apa?” butuh waktu setengah jam untuk dijawab
Pendekatan kedua menaruh definisi itu di YAML. Bedanya paling kelihatan kalau lo lihat dua bentuk ini berdampingan.
Bentuk pertama: konfigurasi di kode
Bentuk paling sederhana dari konfigurasi di kode adalah konstanta. Ini contoh netral, bukan dari framework tertentu:
# retrieval_config.py
RETRIEVAL = {
    "chunk_size": 512,
    "chunk_overlap": 64,
    "top_k": 5,
    "embedding_model": "text-embedding-3-small",
    "reranker": "cross-encoder",
    "hybrid_search": True,
}
Terlihat rapi, dan memang rapi. Masalahnya baru muncul ketika pipeline tumbuh. Konfigurasi ini berpindah jadi kode yang merangkai komponen, dan perubahan sekecil apa pun ikut masuk ke alur build dan deploy.
Bentuk kedua: pipeline sebagai YAML
Haystack menyimpan pipeline sebagai YAML. Struktur tingkat atasnya terdiri dari components, connections, max_runs_per_component, dan metadata. Bentuknya seperti ini, disederhanakan supaya enak dibaca:
components:
  retriever:
    type: InMemoryBM25Retriever
    init_parameters:
      top_k: 5
  prompt_builder:
    type: PromptBuilder
    init_parameters:
      template: "Jawab berdasarkan dokumen berikut: ..."
connections:
  - sender: retriever.documents
    receiver: prompt_builder.documents
max_runs_per_component: 100
metadata: {}
Pipeline itu bisa disimpan dan dimuat kembali sebagai file:
from haystack import Pipeline

pipe = Pipeline()
print(pipe.dumps())                  # pipeline -> YAML (string)
pipe.dump(open("pipeline.yaml", "w")) # pipeline -> file

pipe2 = Pipeline.load("pipeline.yaml")
Perhatikan max_runs_per_component dan metadata. Dua field itu bukan komponen retrieval, tapi ikut jadi bagian dari definisi, karena framework memperlakukannya sebagai konfigurasi, bukan kode.
Contoh dari lapangan
Empat framework ini menaruh definisi flow-nya di file, dengan gaya yang berbeda-beda.
Haystack memakai YAML untuk serialisasi pipeline, seperti contoh di atas. Yang gue suka, timnya sadar satu hal yang sering dilewatkan: file YAML yang bisa memuat kelas dari kode adalah permukaan serangan. Jadi Pipeline.load, Pipeline.loads, dan Pipeline.from_dict menolak mengimpor kelas dari modul di luar daftar tepercaya, dan lo bisa menentukan daftar itu sendiri lewat parameter allowed_modules.
Prompt Flow dari Microsoft menyimpan satu flow sebagai satu folder. Di dalamnya ada flow.dag.yaml yang mendefinisikan node dan hubungan antar node. Konsekuensinya menarik: flow bisa diperlakukan sebagai artefak, bukan sebagai kode aplikasi.
Google ADK memakai root_agent.yaml untuk mendefinisikan agent. Bagian yang bikin beda, file itu punya JSON Schema, dan YAML-nya membawa direktif editor seperti ini:
# yaml-language-server: $schema=https://raw.githubusercontent.com/google/adk-python/refs/heads/main/src/google/adk/agents/config_schemas/AgentConfig.json
Dengan direktif itu, editor bisa memberi peringatan saat lo salah tulis nama field, sebelum pipeline dijalankan. Ini jawaban paling langsung untuk kelemahan YAML yang klasik: tidak ada type checking.
CrewAI memisahkan dua file, config/agents.yaml untuk agent dan config/tasks.yaml untuk task. Satu catatan dari dokumentasinya: knowledge source di CrewAI diatur lewat kode Python, sementara yang masuk YAML adalah definisi agent dan task. Jadi kalau lo berharap seluruh alur knowledge ada di satu file, CrewAI belum sampai ke situ.
Sebagai pembanding, Semantic Kernel punya schema YAML khusus untuk prompt, dan Kubeflow Pipelines mengompilasi pipeline Python menjadi IR YAML sebelum dijalankan. Langflow justru memilih arah sebaliknya: flow-nya disimpan dan diekspor sebagai JSON.
Perbandingannya, satu tabel
| Aspek | RAG ditulis di kode | Knowledge flow di YAML |
|---|---|---|
| Letak definisi | tersebar di beberapa modul | satu file atau satu folder |
| Siapa yang bisa membaca | yang paham kode | termasuk yang bukan engineer |
| Eksperimen parameter | ikut siklus deploy | cukup jalankan ulang pipeline |
| Validasi tipe | dari bahasa pemrograman | hanya kalau framework menyediakan schema |
| Logika bercabang rumit | bebas | terbatas ke bentuk yang didukung |
| Rahasia dan kredensial | environment variable | tetap harus di luar YAML |
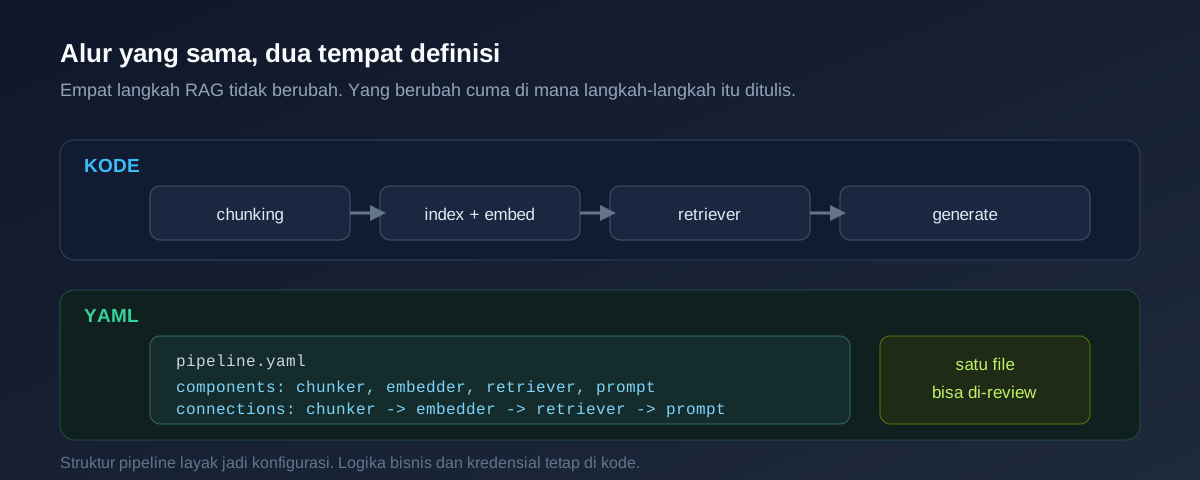
Kalau digambar, bedanya kelihatan seperti ini. Alur RAG-nya sama, yang pindah cuma tempat definisinya.
Kenapa pola YAML bertahan
Empat alasan yang gue lihat, dan semuanya praktis.
Pertama, review. Diff YAML lebih mudah dibaca dibanding diff kode, terutama buat reviewer yang bukan engineer. Perubahan top_k dari 5 ke 8 kelihatan apa adanya, bukan tertimbun di tengah refactor.
Kedua, reproducible. File yang sama menghasilkan pipeline yang sama. Ini terdengar sepele, tapi jadi penting waktu lo perlu membuktikan versi mana yang jalan di production bulan lalu.
Ketiga, model dan retriever bisa diganti tanpa menyentuh kode aplikasi. Untuk tim yang sedang membandingkan beberapa model embedding, ini menghemat banyak siklus.
Keempat, dan menurut gue yang paling menentukan: sistem RAG modern punya banyak parameter. Chunk size, overlap, top_k, nama reranker, hybrid search, bobotnya. Semua itu angka dan nama, bukan logika. Angka dan nama memang tempatnya di konfigurasi.
Jebakannya juga nyata
Terlalu banyak tim yang pindah ke YAML lalu balik lagi, biasanya karena salah satu dari lima hal ini.
YAML itu data, bukan bahasa. Tidak ada type checking, kecuali framework menyediakan schema. Cara paling sehat adalah memakai framework yang menyediakan schema, seperti ADK, dan memasang validasi di CI.
Ambiguitas tipe. Spesifikasi YAML 1.1 menganggap NO, n, off, dan on sebagai boolean. Jadi nilai seperti NO bisa terbaca sebagai false. Kasus ini populer dengan nama Norway problem. YAML 1.2.2 memperbaikinya lewat Core Schema, yang hanya menerima true dan false. Kalau parser yang lo pakai masih mengikuti aturan 1.1, hasil pembacaannya bisa beda.
Deserialisasi yang berbahaya. File konfigurasi yang bisa memuat kelas dari kode adalah pintu masuk. Haystack menanganinya eksplisit lewat allowlist modul yang gue sebut di atas. Kalau framework yang lo pakai tidak punya pengaman seperti itu, anggap file YAML sebagai input yang tidak dipercaya.
Schema bergeser antar versi. Pipeline YAML yang jalan di satu versi mayor belum tentu jalan di versi berikutnya. Ini pekerjaan migrasi yang harus direncanakan, bukan ditemukan lima menit sebelum deploy.
Rahasia. Kredensial tidak punya tempat di file yang ikut di-commit. API key, connection string, dan token tetap di environment variable atau secret manager. Kalau YAML lo butuh nilai rahasia, ambil dari environment, jangan tulis di file.
Jadi pilih yang mana
Kalau logika retrieval lo custom, misalnya query rewriting yang rumit, reranking dengan aturan bisnis, atau multi-hop reasoning, kode memberi ruang yang tidak bisa disediakan YAML. Kalau flow-nya pola standar dan banyak orang perlu membaca atau mengubah parameter, YAML menghemat waktu, terutama waktu reviewer.
Ada satu opsi lagi yang makin relevan: konteks panjang. Studi 2024 tadi menunjukkan model konteks panjang unggul dari sisi performa kalau sumber dayanya cukup, sementara RAG unggul dari sisi biaya. Untuk korpus kecil yang jarang berubah, memuat semuanya ke konteks bisa lebih sederhana daripada membangun pipeline retrieval. Untuk korpus besar yang terus bertambah, RAG masih jadi pilihan yang masuk akal.
Satu catatan soal istilah. Di bidang ini, nama arsitektur sering beredar lebih cepat daripada buktinya. Kalau lo dengar sebutan baru, tanyakan dulu siapa yang memakai, di produk apa, dan di mana dokumentasinya. Pola yang jelas punya jejak dan bisa lo baca sendiri dokumentasinya adalah yang seperti gue sebut di atas: mendefinisikan flow sebagai data, dengan pipeline sebagai konfigurasi.
Kesimpulan
RAG itu arsitekturnya, YAML itu tempat mendefinisikannya, dan dua hal itu bisa hidup bareng. Pipeline YAML di Haystack justru dipakai untuk membangun sistem RAG. Yang berubah adalah di mana lo menaruh keputusan: struktur pipeline, nama komponen, koneksi, dan parameter retrieval layak jadi konfigurasi, sementara logika bisnis dan rahasia tetap di kode.
Kalau lo mau mendalami sisi pengamanan sistem RAG yang sudah jalan, gue pernah nulis tiga fase hardening RAG di blog ini.
Terima kasih sudah membaca sampai habis.