
Empat tahun terakhir, hampir semua orang di industri ini kerja ke satu arah: bikin model yang makin enak diajak ngobrol. Metriknya jelas, demonya enak dilihat, dan hasilnya terasa. Dari RLHF yang ngajarin model menuruti selera manusia, sampai RLVR yang ngasih reward dari jawaban yang beneran terverifikasi. Puncaknya cuma satu: percakapan jadi antarmuka default buat segalanya. Termasuk buat hal yang sebenernya cukup dijawab satu kata.
Terus 15 September 2026 keluar model yang nggak mau ngomong sama sekali. Namanya Jev, dibikin TypeSafe AI. Yang bikin rame di Hacker News bukan cuma modelnya, tapi siapa yang bikin: Diogo Almeida, orang yang sekitar empat tahun kerja di OpenAI di balik RLHF, InstructGPT, ChatGPT, dan GPT-4. Thread peluncurannya nyangkut di 1.977 poin dengan 513 komentar.
Alasan dia keluar dari OpenAI dan bikin benda yang nggak bisa diajak ngobrol itu yang menarik. Ke Forbes dia bilang: “We’ve been optimizing for humans and we’re super human at pleasing humans.” Terjemahan bebasnya: kita udah jago banget bikin mesin yang nyenengin manusia. Yang dia serang bukan kemampuan itu, tapi arah pemakaiannya. Sebab bagian besar keputusan di dalam software nggak butuh disenengin. Ke TechCrunch dia nyebut model percakapan itu seperti “lightning in a bottle” yang justru nggak kepake.
Artikel ini gue susun empat bagian: konteks kenapa dia muncul sekarang, apa sebenarnya Jev, bedanya sama LLM, dan kenapa ini menarik plus di mana jebakannya.
Kenapa Baru Muncul Sekarang
Sekilas aneh. Semakin pintar LLM, semakin gampang kita bikin keputusan terstruktur dari output teks, kan? Tinggal minta model balikin JSON, parse, validasi, selesai.
Kenyataannya nggak sesederhana itu. Tiap keputusan terstruktur di dalam kode harus dipaksa keluar sebagai teks, terus di-parse, terus divalidasi, terus dikasih guardrail kalau meleset. Lapisan-lapisan inilah yang jadi tempat paling rapuh di sistem AI hari ini. Dan biayanya kelihatan di dua tempat: waktu dan duit. Di halaman resminya, TypeSafe nulis waktu respons ujung ke ujung model frontier ada di kisaran 3 sampai 329 detik. Buat ngobrol sama manusia itu cukup. Buat dipanggil di dalam kode yang lagi melayani request, itu penghalang.
Jadi Jev muncul bukan karena LLM gagal, tapi karena satu pekerjaan spesifik salah titip. Keputusan terstruktur dititipin ke alat yang dirancang buat menulis kalimat.
Timnya sendiri lumayan serius. TypeSafe AI perusahaan San Francisco yang berdiri 2024, dikembangkan sekitar dua tahun dalam mode stealth, dan rilis Jev bareng pengumuman seed US$40 juta dipimpin DCVC. Forbes nulis valuasi di kisaran US$200 juta. Founder-nya tiga orang: Diogo Almeida sebagai CEO, Erik Gafni, dan Sasha Sheng. Nama Jev sendiri diambil dari William Stanley Jevons, ekonom abad ke-19 yang namanya nempel di Jevons paradox: makin efisien pemakaian sebuah sumber daya, makin banyak juga yang dikonsumsi. Alasan Almeida pilih nama itu sederhana: kalau machine intelligence makin murah, pemakaiannya justru makin luas.
Reaksi industri di minggu pertama cukup ramai. Selain thread utama, muncul tiruan versi open source (Kev, keluarga model keputusan kecil di atas Qwen3.5, 459 poin), benchmark pihak ketiga (JevBench dari Benchmark Heaven, 140 poin), sampai thread “OpenAI is well positioned to fast-follow Jev” yang juga naik ratusan poin. Kalau sebuah rilis bikin orang nulis ulang implementasinya dalam dua puluh lima baris Python, biasanya ada yang beneran berubah.
Apa Sebenarnya Jev
Jev itu model proprietary. Bukan open weight, bukan produk chat, dan nggak bisa lo buka lewat aplikasi. Cara pakainya lebih mirip pemanggilan fungsi:
- lo kirim satu blok state, isinya string, objek JSON, atau array teks
- lo lampirin satu atau beberapa pertanyaan bertipe
- yang balik bukan teks, tapi nilai bertipe lengkap dengan estimasi probabilitas dan confidence score
Menariknya, semua pertanyaan dievaluasi dalam satu lintasan paralel. Jadi modelnya nggak nulis jawaban satu per satu, dia ngukur semua pertanyaan sekaligus.
Ada tiga tipe pertanyaan alias primitif di versi sekarang:
| Primitif | Fungsi | Yang dibalikin |
|---|---|---|
| Choice | pilih satu opsi dari daftar yang lo tentukan | opsi terpilih, probabilitas per opsi, confidence |
| Score | nilai state terhadap level berurutan | skor, probabilitas per level, confidence |
| Noul | evaluasi pernyataan ya/tidak | probabilitas antara 0 dan 1 |
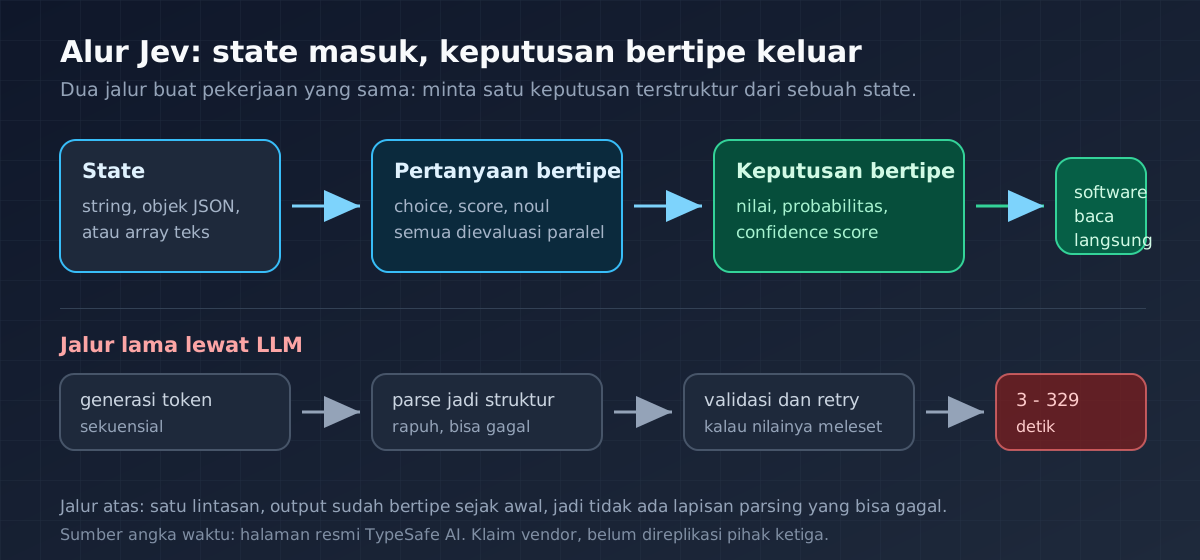
Kunci desainnya ada di satu kalimat TypeSafe sendiri: karena opsi jawaban ditentukan di depan, model secara struktural nggak bisa balikin nilai di luar skema yang lo kasih. Nggak ada JSON malformed, nggak ada nilai karangan yang nggak ada di daftar. Ini yang mereka sebut sebagai hilangnya kelas bug parsing, bukan berkurangnya.
Kelas model ini mereka namai System One models, nyerempet dikotomi System 1 dan System 2 punya Kahneman: keputusan cepat dan reflektif, versus penalaran lambat yang mendalam. Jev sengaja ambil sisi pertama. Metode latihannya juga beda: RLCD, Reinforcement Learning for Calibrated Decisions. Kalau RLHF mengoptimasi ke selera rater manusia, RLCD mengoptimasi probabilitas terhadap hasil yang beneran terjadi. Jadi angka 0,87 itu punya arti, bukan sekadar retorika model yang percaya diri.
Bedanya Sama LLM
Ini tabel dari halaman resmi TypeSafe, jadi anggap sebagai klaim vendor, bukan hasil pengukuran pihak ketiga:
| Aspek | LLM | Jev (System One) |
|---|---|---|
| Latihan | RLHF / RLVR | RLCD |
| Yang dioptimasi | selera manusia, reward terverifikasi | kalibrasi probabilitas terhadap outcome |
| Input | teks, menekankan pesan berurutan | teks, menekankan structured program state |
| Output | string, harus di-parse dan divalidasi | nilai bertipe, probabilitas dan confidence |
| Sampling | sekuensial, satu token tiap langkah | paralel, semua jawaban sekali jalan |
| Biaya | input $0,20 sampai $10 per MTok, output sekitar 5x input | input $0,042 per MTok, output dihitung gratis |
| Waktu respons | 3 sampai 329 detik | 70 sampai 500 milidetik |
Kesimpulan gue: Jev bukan LLM versi lebih murah. Dia melepas kemampuan menulis sebagai fitur, bukan sebagai kelemahan. LLM itu kayak rekan kerja yang nulis laporan lengkap. Jev itu tombol yang bisa jelasin alasan dia nyala. Dua-duanya kepake, cuma di tempat yang beda.
Kenapa Ini Menarik
Pertama, kelas bug-nya hilang, bukan dikurangi. Selama ini lapisan paling rapuh di sistem AI adalah parsing dan validasi output. Kalau output-nya udah bertipe sejak awal, lapisan itu nggak perlu ada. Ini penghematan kode, bukan cuma penghematan token.
Kedua, keputusan AI jadi layak masuk jalur panas. Di latensi detikan, agent cuma bisa mikir di luar request user. Di ratusan milidetik, dia bisa mikir di dalam request. Bedanya kelihatan di produk: bukan lagi tombol “analisa dokumen ini” yang hasilnya muncul 30 detik kemudian, tapi sistem yang mutusin routing dan eskalasi sambil user nunggu.
Ketiga, probabilitas terkalibrasi ngubah cara desain. Kalau output-nya angka, lo bisa setel threshold, bikin aturan eskalasi ke manusia, dan nyimpen jejak audit dari keputusan. Yang nggak bisa dilakuin kalau output-nya paragraf.
Keempat, ekosistemnya kebuka cepat. Tiga hari setelah Jev rilis udah muncul laya, implementasi open source Apache-2.0 dengan sekitar 21 ribu bintang di GitHub. Isinya encoder ModernBERT-large 421M, klaimnya 33 milidetik di satu GPU T4 dan 7,2 milidetik per pertanyaan kalau di-batch. Server HTTP-nya kompatibel sama API Jev, dan ada versi multibahasa dengan 100+ bahasa. Selain itu muncul juga replikasi open weight yang lain, misalnya von (klaimnya di bawah 15 milidetik) dan openjev, plus JevBench yang sampai sekarang membandingkan Jev dengan lebih dari 80 sistem sekelas. Artinya buat yang nggak mau percaya begitu aja, ada jalur buat self-host dan ngukur sendiri.
Kalau Mau Mulai, Mulai dari yang Kecil
Gue nggak saranin langsung ganti semua panggilan LLM di sistem lo. Pola yang paling aman itu bertahap:
- Satu node dulu. Ambil satu tempat di kode yang sekarang manggil LLM buat klasifikasi atau routing, ganti jadi satu pertanyaan bertipe. Ukur akurasi dan latensinya.
- Lanjut ke guardrail dan triage paralel. Di sini keunggulan sampling paralel kerasa: sepuluh pertanyaan sekaligus bukan berarti sepuluh kali pemanggilan.
- Baru naik ke lapisan keputusan di orkestrasi agent. Ini kebutuhan paling berat, dan justru di sini trade-off-nya paling kelihatan.
Di Mana Jebakannya
Ini bagian yang gue nggak mau dilewatin, karena di sinilah banyak tulisan teknologi berhenti terlalu cepat.
Angka 40 sampai 200 kali lebih cepat, dan 40 sampai 400 kali lebih murah itu klaim TypeSafe sendiri. Yang lebih penting, mereka sendiri nulis bahwa workflow benchmark-nya dibikin tim internal dan mengakui ada potensi bias. Angka puncaknya, 193,6 kali lebih cepat dan 444,6 kali lebih murah, datang dari workflow internal mereka juga. Jadi yang belum direplikasi pihak ketiga itu angka performanya, bukan idenya. Antarmuka System One-nya justru udah banyak diimplementasi ulang orang lain.
Satu detail lagi yang layak diketahui: benchmark itu nggak dibandingin ke kunci jawaban objektif. Tiap model diukur terhadap rata-rata probabilitas dari dua model besar eksternal yang dibungkus supaya bisa ngeluarin jawaban bertipe. Pihak ketiga yang nge-review angka ini nyebut klaim penghematan 445 kali itu sebagai self-tested, dan itu catatan yang wajar.
Arsitektur, bobot, dan paper-nya nggak dipublikasi. Yang mereka sampaikan cuma klaim berbasis transformer dan dilatih sepenuhnya pakai synthetic data. Pengamat luar menduga ini jalan di atas LLM open weight, tapi itu belum dikonfirmasi. Perlakukan sebagai dugaan, bukan fakta.
“Nggak bisa halusinasi” itu klaim soal ruang output, bukan jaminan selalu benar. Secara struktural, model nggak bisa balikin opsi di luar skema. Tapi apakah nilainya tepat, pilihan mana yang paling benar, tetap bergantung ke kalibrasi probabilitasnya. Output yang rapi belum otomatis berarti output yang tepat.
Harga dan batasan API-nya baru ada di blog dan dokumentasi resmi. Belum ada pihak ketiga yang memverifikasi di luar itu.
Jadi posisi Jev menurut gue jelas: menarik buat diuji, belum terbukti buat dipercaya. Dan justru karena ada alternatif open source yang bisa dijalanin sendiri, menguji itu sekarang murah.
Kesimpulan
Selama ini kita ngajarin mesin buat ngomong. Jev ngingetin kalau sebagian besar keputusan di dalam software sebenernya cukup dijawab tanpa satu kalimat pun. Yang dia tawarin bukan LLM yang lebih pintar, tapi alat yang bentuknya cocok buat pekerjaan yang selama ini kita paksa masuk ke alat yang salah.
Buat yang mau ngecek sendiri, sumbernya di sini: pengumuman resmi TypeSafe AI, halaman Wikipedia Jev yang merangkum Forbes, TechCrunch, dan The Register, thread Hacker News, laya di GitHub, JevBench dari Benchmark Heaven, dan review pihak ketiga soal klaim biayanya.
Terima kasih udah baca sampai habis.